 AFM Studio
Compression Lab
 Compression Lab
Lab interaktif yang menunjukkan biaya menyimpan teks, dengan ukuran model kompresornya ikut dihitung
- tingkat ingatan model, masing-masing diukur
- 6
- kompresor, masing-masing dengan decoder teruji
- 3
- bahasa dalam perbandingan teks paralel
- 4
- pustaka kompresi atau grafik yang dipakai
- 0
Di halaman ini
Masalahnya
Kebanyakan penjelasan tentang kompresi data mengajarkan tiga algoritma dan menyiratkan ada satu "batas entropi" yang didekati semuanya. Gambaran itu keliru, dan kekeliruannya justru menarik. Seberapa hemat sebuah teks bisa disimpan bergantung pada seberapa banyak yang diingat oleh kompresornya. Kalau ia melihat satu huruf sebelumnya, biayanya turun. Kalau melihat dua huruf, turun lagi. Tapi setiap langkah membuat modelnya makin besar, dan model itu harus ikut disimpan bersama datanya.
Jadi ukuran sebenarnya adalah teks terkompresi ditambah modelnya, dan ada titik terbaik yang bergeser mengikuti panjang teks. Penjelasan yang ada tidak pernah menghitung modelnya, sehingga pertukaran itu tidak pernah terlihat. Saya membuat Compression Lab untuk mahasiswa, engineer otodidak, dan siapa pun yang samar-samar masih ingat Huffman coding dari kuliah.
Yang saya bangun
Satu grafik memuat seluruh argumennya
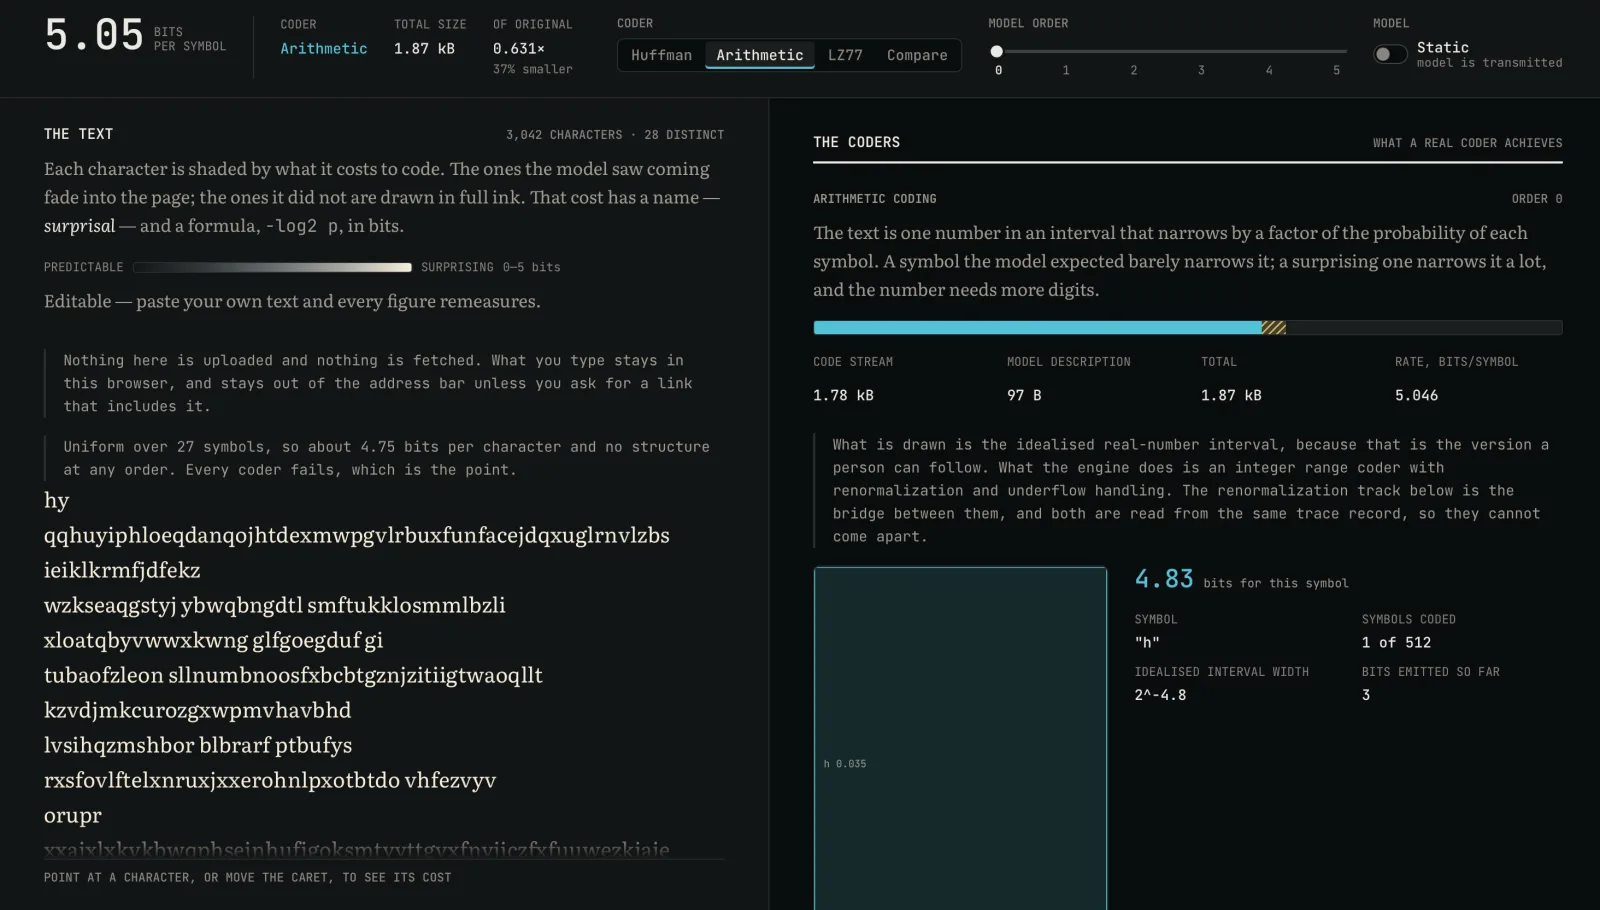
Grafik utamanya menampilkan enam tingkat ingatan model sebagai anak tangga yang menurun. Di atasnya digambar laju yang dicapai setiap kompresor, ukuran model sebagai kurva yang naik, dan totalnya sebagai kurva ketiga dengan titik terendah yang ditandai. Tempelkan teks yang lebih panjang, dan titik terendah itu bergeser ke kanan. Momen itu menyampaikan argumennya tanpa perlu satu paragraf penjelasan.
Ukuran model diukur per byte
Saya menulis kode yang menyimpan setiap model sebagai deretan byte dan kode yang membacanya kembali. Tes memastikan decoder yang hanya diberi teks terkompresi dan byte model itu bisa membangun ulang teks aslinya dengan tepat, di setiap tingkat. Biaya model di layar adalah panjang byte tersebut. Kalau angka itu hanya perkiraan, titik terendah di grafik akan jadi karangan.
Setiap kompresor bisa membalik hasilnya
Tidak ada yang memakai aplikasi ini untuk dekompresi. Tapi kompresor tanpa pasangan dekompresornya belum terbukti, padahal klaim aplikasi ini adalah angkanya benar. Jadi ketiga kompresor punya decoder, dan tes mengujinya bolak-balik dengan input yang merepotkan: string kosong, satu karakter, karakter di luar rentang Unicode dasar, dan semua contoh bawaan.
Gambarnya memutar ulang perhitungan yang sebenarnya
Setiap kompresor mencatat apa yang dilakukannya saat berjalan: urutan Huffman menggabungkan simbol, tempat jendela geser menemukan kecocokan, dan interval di setiap langkah arithmetic coding. Tampilan menggambar catatan itu dan tidak pernah menjalankan algoritmanya untuk kedua kali. Teks kita sendiri juga diwarnai huruf demi huruf sesuai jumlah bit yang dibutuhkannya, jadi strukturnya muncul saat ingatan model dinaikkan.
Uji empat bahasa yang melaporkan kedua hasilnya
Aplikasi ini membandingkan Deklarasi Universal Hak Asasi Manusia yang sama dalam bahasa Inggris, Indonesia, Jerman, dan Finlandia. Gagasan yang diuji: bahasa yang membentuk kata dari tumpukan imbuhan menyimpan pengulangan tersembunyi yang bisa ditemukan oleh pencocokan pola. Bahasa Indonesia mendapat keuntungan terbesar. Bahasa Finlandia, yang paling kaya imbuhan di antara keempatnya, tidak. Halaman ini melaporkan keduanya dan menyatakan bahwa empat teks tidak cukup untuk menjawab pertanyaan itu.
Hasilnya
Compression Lab sudah live, dengan halaman terpisah yang menjelaskan metodenya. Seluruh mesinnya adalah kode saya sendiri: model frekuensi, Huffman coding, arithmetic coding, dan kompresor jendela geser. Tidak ada pustaka kompresi, statistik, atau grafik yang dipakai. Menghitung ulang keenam tingkat butuh sekitar 14 milidetik di mesin saya, masih di dalam anggaran 16 milidetik, jadi grafik diperbarui selagi kita mengetik. Tidak ada teks yang ditempel yang keluar dari browser. Saya membangunnya selama dua hari, 2 dan 3 September 2026.
Di balik layarDetail teknis untuk engineer
src/engine/tidak meng-import apa pun: tanpa React, tanpa DOM, tanpaMath.random, tanpaDate. Kodenya jalan apa adanya di test runner Node biasa.- Orde model 0 sampai 5, statis dan adaptif, dengan tiga coder: Huffman (canonical code), integer arithmetic range coder, dan LZ77 dengan match finder hash-chain. Semuanya diuji bolak-balik, termasuk teks di luar Basic Multilingual Plane.
serialiseModel/deserialiseModelmendefinisikan format byte yang nyata. Biaya model di UI adalahmodelBytes.length * 8. Biaya model adaptif tidak nol: hitungannya gratis, tapi alfabet dan jumlah simbolnya dikirim. Deskripsi adaptif orde 3 sekitar seperlima puluh dari versi statisnya.- Arithmetic coder floating-point
[0,1)rusak setelah sekitar lima belas simbol, jadi mesinnya memakai register integer dengan renormalisasi dan penanganan underflow. Tampilan zoom adalah interval bilangan riil yang diidealkan, dengan jalur renormalisasi dan buku bit di bawahnya. - Di 32 bit, pembagian floor meleset 1,54 bit lebih tinggi pada teks orde 4 sepanjang 10.000 simbol. Saya melebarkan register ke 48 bit dan tidak mengubah toleransinya.
- Model
Map<string, Map<string, number>>butuh 250 ms untuk menghitung ulang 10.000 karakter. Hitungannya sekarang berupa integer yang di-intern, dibangun untuk keenam orde dalam satu kali lewat dan di-cache per input. Di atas 50.000 karakter, aplikasi menghitung ulang saat idle dan memberitahukannya. - Tes performa menuntut p90 di bawah 16 ms secara lokal (terukur 14,4 ms) dan menjadi penjaga regresi 32 ms di CI, tempat runner bersama mengukur 17,0 ms.
- Korpus paralel, keunggulan LZ77 atas H₀ dalam bit per simbol: Indonesia 0,851, Inggris 0,636, Finlandia 0,340.
- Contoh teks di-bundle dengan import
?rawdari Vite; apa pun dipublic/akan jadi permintaan jaringan saat runtime. Teks yang diketik tidak masuk ke state URL; ada aksi salin tautan yang terpisah. - Enam tampilan SVG buatan tangan, satu loop
requestAnimationFrameuntuk zoom interval. Tempelan 200.000 karakter tetap bisa di-scroll karena permukaan teksnya divirtualisasi. - Di luar cakupan: LZW, BWT, PPM, ANS, DEFLATE, input biner, unggah berkas, dan papan peringkat.
- Dependensi runtime:
reactdanreact-dom. Bundle 94 KB JS gzip ditambah 7 KB CSS dari anggaran 200 KB. 64 tes di 12 berkas, sekitar 9.800 baris, 41 commit.
Tangkapan layar
Sedang merekrut, atau membangun hal serupa?
Saya terbuka untuk posisi full-time dan proyek freelance tertentu.