 AFM Studio
Language Lineage
 Language Lineage
Peta percabangan bagaimana rumpun bahasa terpecah sepanjang sejarah, dengan setiap klasifikasi yang diperdebatkan menampilkan bukti dari kedua sisi
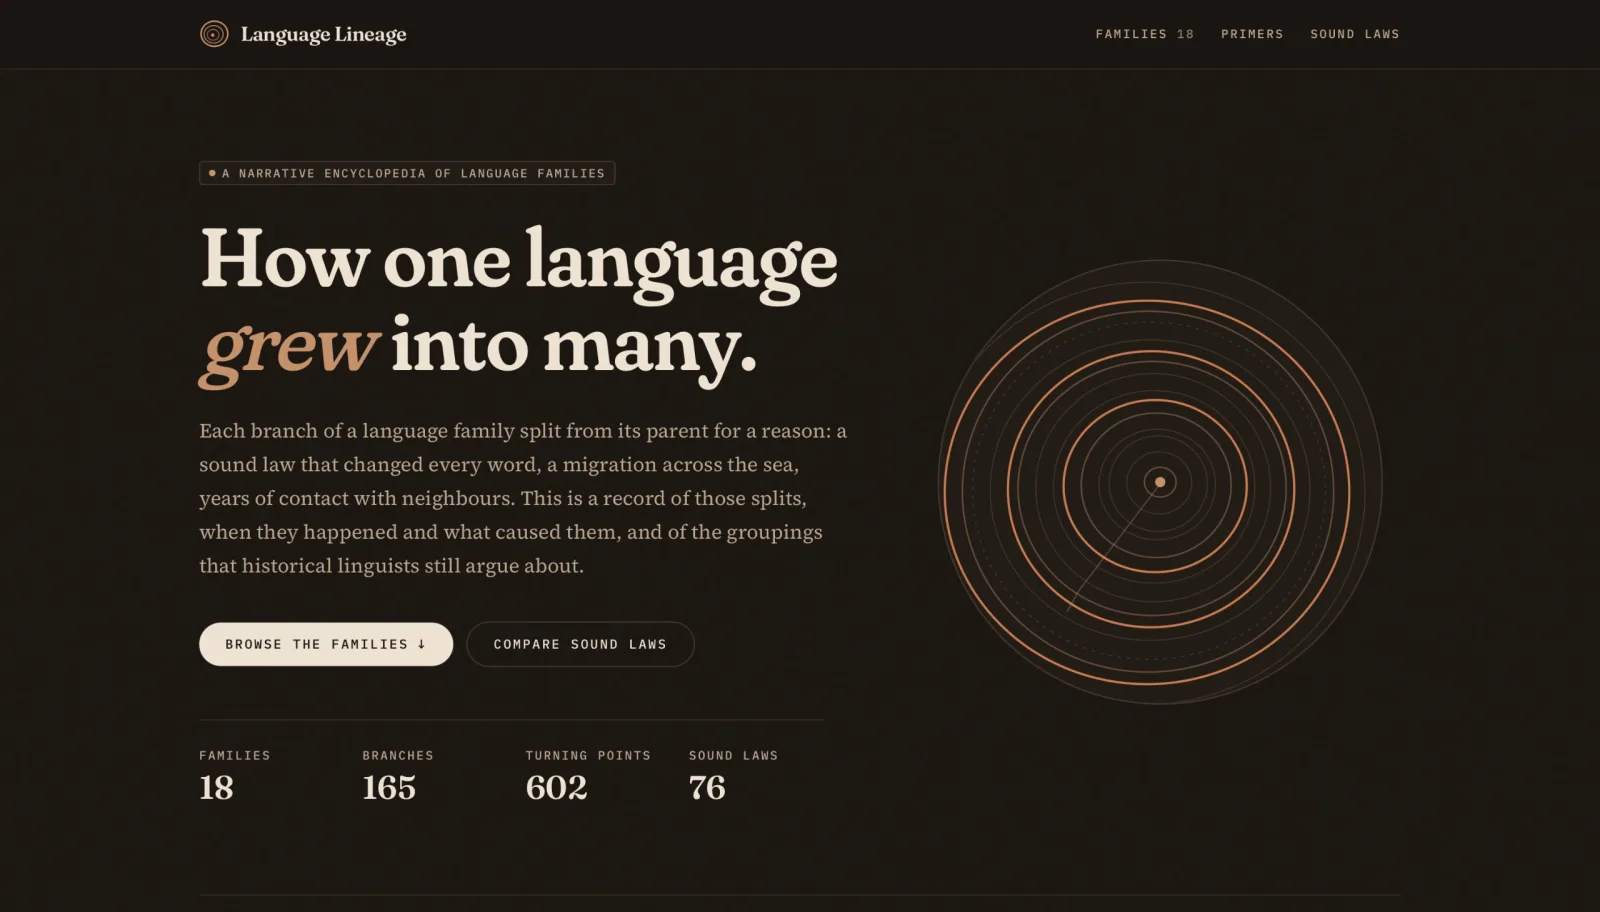
- rumpun bahasa dicakup, dari akar sampai kini
- 18
- titik balik, masing-masing dengan sumber terkutip
- 602
- klasifikasi diperdebatkan dengan bukti dari kedua sisi
- 77
- tokoh sejarah terindeks per titik balik
- 67
Di halaman ini
- Masalahnya
- Yang saya bangun
- Satu cabang bisa punya lebih dari satu leluhur
- Setiap klasifikasi yang diperdebatkan membawa bukti dari kedua sisi
- Saya menulis sendiri tata letak cabangnya alih-alih memakai pustaka graf
- Kontennya hidup sebagai berkas JSON di repositori, tanpa basis data atau backend
- Proses build sendiri menangkap kesalahan data sebelum dirilis
- Hasilnya
- Di balik layar
Masalahnya
Kebanyakan pembaca mengenal sebuah rumpun bahasa sebagai fakta yang sudah selesai. Germanik Barat begitu saja dianggap terpisah dari Proto-Germanik, tanpa ada yang menjelaskan kenapa sebagian ahli masih menolak "Altaic" sebagai rumpun bahasa yang sungguhan. Konteks itu ada di sumber akademik: Glottolog, katalog hukum bunyi, monografi perorangan. Tapi semuanya ditulis untuk sesama linguis, tersebar di literatur spesialis yang tak bisa begitu saja diikuti pembaca awam.
Saya membangun Language Lineage untuk orang tanpa latar belakang linguistik: siapa pun yang penasaran dari mana nenek moyang bahasanya berasal. Klasifikasi linguistik historis tak selesai dengan riset lebih lanjut seperti halnya soal matematika terbuka; lebih banyak riset tak akan menentukan apakah "Altaic" itu rumpun bahasa yang nyata. Jadi situs ini menampilkan perselisihan yang masih hidup, bukan satu pohon yang sudah dirapikan: siapa berargumen apa, dan seberapa mapan tiap klaimnya.
Yang saya bangun
Satu cabang bisa punya lebih dari satu leluhur
Perubahan akibat kontak bahasa, seperti kreol, sprachbund, dan difusi areal, bisa membuat satu cabang punya lebih dari satu leluhur. Saya memodelkannya sebagai DAG sejak commit pertama: tiap cabang menyimpan daftar id induk, dan algoritma tata letaknya dibangun sejak awal untuk menangani lebih dari satu induk, bukan ditambal belakangan.
Setiap klasifikasi yang diperdebatkan membawa bukti dari kedua sisi
Perselisihan rumpun besar seperti Altaic, Nostratic, dan Austric adalah perdebatan ilmiah yang masih hidup, bukan soal yang sebenarnya sudah terpecahkan tapi belum dipublikasikan, jadi memilih satu sisi akan salah menggambarkan keadaan bidang ini. Tiap kelompok yang diperdebatkan punya rekamannya sendiri: status (diterima luas, posisi minoritas, sebagian besar ditolak), bukti yang mendukungnya, dan bukti yang menentangnya, digambar di pohon dengan garis putus-putus dan lambang cincin.
Saya menulis sendiri tata letak cabangnya alih-alih memakai pustaka graf
Cabang bisa punya lebih dari satu induk, jadi linimasa linear biasa saja tak cukup, tapi pohon tiap rumpun tetap kecil, sampai belasan cabang, yang tak cukup untuk membenarkan dependensi tata letak graf yang umum. Tata letaknya menghitung lapisan tiap cabang, lalu mengurutkan dan menghaluskannya agar pohon tetap terbaca, digambar sebagai cincin pertumbuhan seperti yang saya inginkan. Saya kembali menyesuaikannya lebih dari sekali seiring pohon rumpun melebar dari uji coba awal.
Kontennya hidup sebagai berkas JSON di repositori, tanpa basis data atau backend
Setiap rumpun dan cabang adalah satu berkas JSON, jadi sebuah koreksi adalah pull request satu berkas. Model yang sama yang saya pakai di situs referensi statis saya yang lain, tanpa panel admin, tanpa login. Semuanya dibangun menjadi HTML statis tanpa server yang perlu dijalankan dan tanpa akun yang perlu diamankan.
Proses build sendiri menangkap kesalahan data sebelum dirilis
Dengan 165 berkas cabang yang ditulis tangan, id yang salah atau kutipan yang bermasalah baru akan terlihat sebagai halaman rusak setelah ter-deploy. Validatornya menolak induk yang tak dikenal, siklus di graf cabang, dan, ditambahkan belakangan, titik balik apa pun yang tanggalnya lebih baru dari semua sumber yang mengutipnya. Commit yang rusak tak bisa sampai ke produksi.
Hasilnya
Language Lineage sudah live. Situs ini memetakan 18 rumpun bahasa dari proto-bahasa sampai kini, dengan 602 titik balik bersumber, 77 klasifikasi yang diperdebatkan yang masing-masing menampilkan bukti dari kedua sisi, dan 67 tokoh sejarah terindeks berdasar peristiwa yang terkait dengannya. Saya membangunnya sendirian selama lima hari pada September 2026, menulis sendiri konten tiap rumpun, lalu merangkai peta dunia dan tampilan perbandingan hukum bunyi di atas data yang sama.
Di balik layarDetail teknis untuk engineer
- Next.js 14, static export (
next build→out/); tanpa server runtime di produksi. src/lib/treeLayout.tsadalah tata letak DAG berlapis buatan tangan, digambar olehsrc/components/LineageTree.tsxdengan D3 7.9 dan animasi tumbuh/muncul; menangani cabang dengan lebih dari satu induk, serta tata letak rantai maupun kipas (kipas datar ketika tak ada subkelompok antara yang cukup didukung, misalnya Austroasiatic dan Pama-Nyungan).Branch,TurningPoint(bertipe SPLIT / SOUND_LAW / CONTACT / WRITING_SYSTEM_ADOPTED / EXTINCTION / REVITALIZATION),ContestedClassification, danFiguredidefinisikan disrc/lib/types.ts; konten dibaca saat build dari JSON lewatsrc/lib/content.ts, tanpa basis data atau lapisan data runtime.- Titik balik hukum bunyi membawa metadata perbandingan tambahan (
process,notation,sort_year) sehingga/sound-lawsbisa memplot setiap hukum bunyi dari 18 rumpun pada satu linimasa dan matriks yang sama. src/lib/worldMap.tsmembangun choropleth per negara daritopojson-clientdanworld-atlas, digerakkan oleh data penutur/negara per cabang; indikator vitalitas bergaya UNESCO digambar per bahasa lewatsrc/components/Vitality.tsx.- Transkripsi IPA dan bentuk rekonstruksi digambar sebagai teks sungguhan dalam Gentium Plus, bukan gambar, sehingga tetap bisa diseleksi dan dicari.
- Contoh kalimat mengatur arah teksnya secara otomatis, sehingga contoh berbahasa Arab, Ibrani, dan Suryani tampil dari kanan ke kiri; font judul jatuh ke Source Serif 4 untuk diakritik Latin-perluasan yang tak digambarnya dengan baik.
scripts/validate-content.mjsberjalan sebelum tiap build dan menggagalkannya pada induk yang tak dikenal, tabrakan id antar-cabang, siklus, dan titik balik apa pun yang tanggalnya lebih baru dari semua sumber yang mengutipnya.- Di-deploy lewat GitHub Actions saat push ke
main: build dengan base path yang diaturactions/configure-pages, lalu diterbitkan lewatactions/upload-pages-artifactdanactions/deploy-pages. - Tanpa basis data dan tanpa framework pengujian di mana pun dalam proyek ini;
tsc --noEmitadalah satu-satunya pemeriksaan otomatis lain selain validasi konten. - 329 commit dalam 5 hari, 23 sampai 27 September 2026. 3.941 baris TypeScript dan TSX di 6 template route dan 21 komponen, ditambah 18.441 baris konten JSON.
Tangkapan layar
Sedang merekrut, atau membangun hal serupa?
Saya terbuka untuk posisi full-time dan proyek freelance tertentu.