 AFM Studio
Lontara
 Lontara
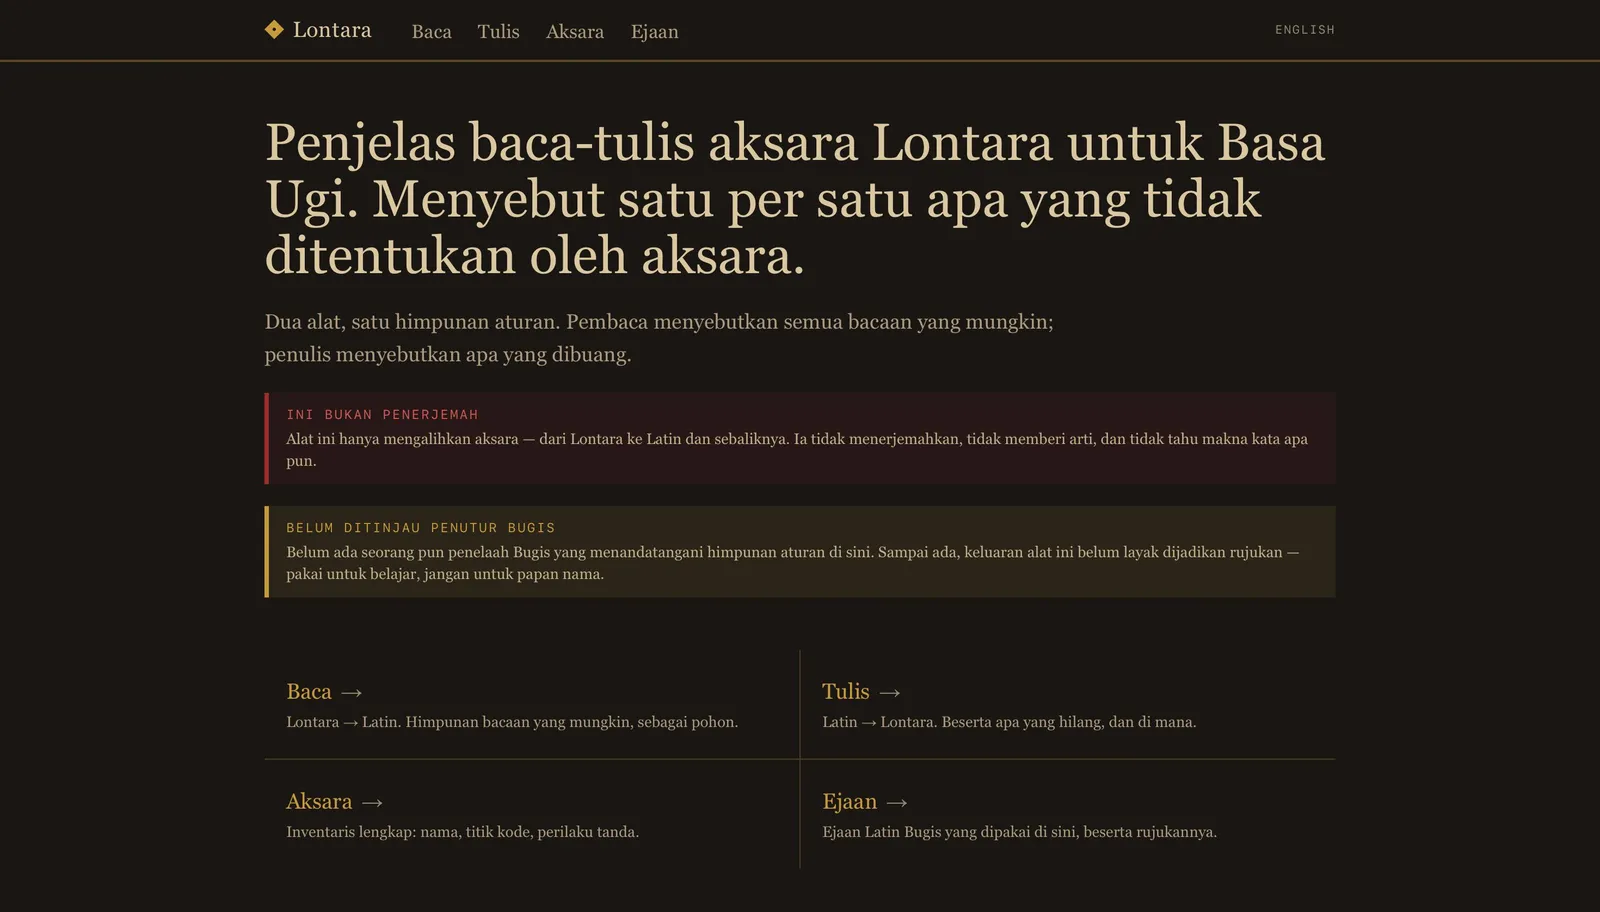
Pembaca dan penulis aksara Lontara Bugis yang mendaftar semua bacaan saat aksaranya tidak menentukan kata
- cocok dengan pasangan Wikipedia Bugis, naik dari 56%
- 94%
- entri daftar kata, masing-masing dengan sumbernya
- 1.323
- pasangan Lontara–Latin tulisan pengguna Bugis
- 97
- pertanyaan ejaan dicatat sebagai terbuka
- 7
Di halaman ini
- Masalahnya
- Yang saya bangun
- Alat ini mendaftar semua bacaan yang dimungkinkan aksara
- Aturan ejaan bisa dibaca oleh peninjau
- Bacaan diambil dari daftar kata, tidak pernah dari aturan tebakan
- Tulisan Bugis asli menemukan tingkat kesalahan 56%
- Daftar kata hanya mengklaim yang bisa dibuktikan
- Hasilnya
- Di balik layar
Masalahnya
Lontara adalah aksara bahasa Bugis dari Sulawesi Selatan. Aksara ini punya 23 konsonan dan lima tanda vokal, tapi tidak punya cara untuk menulis konsonan mati. Akibatnya, konsonan di akhir suku kata, konsonan rangkap, bunyi sengau sebelum konsonan, dan hamzah tidak pernah tertulis. Kata mata, matta, dan manta ditulis persis sama. Pembaca manusia menentukan kata yang dimaksud dari kosakata dan konteks.
Konverter yang ada menyembunyikan hal ini. Mereka menerima Lontara dan mengeluarkan satu ejaan Latin yang yakin, padahal itu tebakan yang disajikan sebagai jawaban. Pembuat papan nama bisa memasang nama yang salah eja di papan permanen. Pelajar bisa diajari aturan yang tidak ada. Orang yang membaca naskah keluarga hanya mendapat satu bacaan padahal ada enam yang sah, tanpa tanda bahwa sebuah pilihan sudah dibuat.
Yang saya bangun
Alat ini mendaftar semua bacaan yang dimungkinkan aksara
Tempelkan Lontara ke pembaca, dan hasilnya berupa pohon bacaan Latin yang mungkin. Setiap titik cabang diberi label jenis ambiguitas penyebabnya: konsonan akhir, konsonan rangkap, bunyi sengau, atau hamzah. Setiap pilihan yang dibuat alat ini wajib membawa alasan, jadi tidak ada bacaan yang dipilih diam-diam. Penulis bekerja ke arah sebaliknya. Ia menata huruf Latin menjadi aksara di atas pita daun lontar dan menandai informasi yang hilang tepat di garis penghubung tempat informasi itu jatuh.
Aturan ejaan bisa dibaca oleh peninjau
Kesebelas aturan ejaan disimpan di berkas data, masing-masing bertanda dikutip, sementara, atau diturunkan, lengkap dengan kutipannya. Kodenya hanya menafsirkan berkas itu. Penutur Bugis yang tidak bisa memprogram harus tetap bisa mengaudit ejaannya, dan satu halaman di aplikasi menampilkan setiap aturan beserta sumbernya.
Bacaan diambil dari daftar kata, tidak pernah dari aturan tebakan
Cara yang paling jelas adalah mencoba setiap konsonan yang mungkin menutup tiap suku kata. Itu butuh daftar konsonan akhir dalam bahasa Bugis, dan saya tidak menemukan sumber yang bisa dikutip. Menebaknya akan menghasilkan bacaan yang tampak meyakinkan padahal bukan bahasa Bugis. Jadi sebuah bacaan hanya dihitung kalau ia kata yang dikenal dan, saat ditulis ulang, menghasilkan Lontara yang persis sama. Akibatnya, kelengkapan hasil bergantung pada daftar kata, dan setiap hasil menyebutkannya.
Tulisan Bugis asli menemukan tingkat kesalahan 56%
Wikipedia bahasa Bugis memuat pasangan Lontara dan Latin yang ditulis oleh para penggunanya. Saya mengambil 97 pasangan dan mengukur aturan saya terhadapnya. Kecocokannya hanya 56%. Pengujian itu menemukan tiga kesalahan. Dua huruf vokal ternyata kebalikan dari yang tersirat di nama Unicode-nya, é sama sekali belum ada, dan hamzah dalam praktiknya ditulis q. Setelah diperbaiki, kecocokannya naik ke 94%. Dua kejanggalan lain, masing-masing dengan dua kasus, mungkin kesalahan di artikelnya, jadi saya menyimpannya untuk peninjau.
Daftar kata hanya mengklaim yang bisa dibuktikan
Daftar katanya berisi 1.323 entri, dan setiap entri mencatat asalnya. Ternyata 85% isi dump sumbernya adalah artikel rintisan buatan bot, jadi daftar ini tidak mengklaim seberapa sering sebuah kata dipakai, dan build gagal kalau ada entri yang mengklaimnya. Sebagian entri adalah nama tempat berbahasa Indonesia, Inggris, atau Vietnam yang tidak bisa dibedakan dari kata Bugis, jadi pembaca memberi lencana pada bacaan itu dan menaruhnya di peringkat bawah.
Hasilnya
Lontara sudah live dan terbuka untuk umum, dalam bahasa Indonesia dan Inggris, dan tetap berjalan offline setelah kunjungan pertama. Ada papan ketik Lontara di layar, karena kebanyakan ponsel tidak punya. Menurut aturannya sendiri, aplikasi ini sudah di-deploy tapi belum diluncurkan. Belum ada peninjau Bugis yang menyetujuinya, kodenya menegakkan syarat itu, dan setiap halaman menyebutkannya. Halaman ejaan memuat tujuh pertanyaan terbuka yang saya catat alih-alih ditebak. Aplikasi ini menyatakan dengan jelas bahwa ia proyek pribadi, bukan otoritas, dan bisa keliru. Ia mengalihaksarakan, tidak menerjemahkan. Saya membangunnya sendiri dalam enam hari, dari akhir Juli sampai awal Agustus 2026.
Di balik layarDetail teknis untuk engineer
- Karakter diambil dari blok Unicode Buginese (U+1A00–U+1A1F), yang tidak punya virama. Huruf Latin e memakai U+1A1B dan é memakai U+1A19, kebalikan dari yang tersirat di nama karakternya.
- Aturan ada di
data/rules/rules.json: rule set v0.2.0, 11 aturan dalam 4 tahap (5cited, 2provisional, 4derived).pnpm rules:reportmencetaknya;/ejaanmenampilkannya. - Engine-nya murni:
(input, direction, options, ruleSet, lexicon) => TransliterationTrace, ditegakkan oleh override ESLint dantests/invariants.test.ts.interpret.tsmenulis;enumerate.tsmembaca dengan membalik penulis terhadap leksikon. - Ambiguitas berbentuk
{ class, candidates, chosen, reason, spans }denganreasonwajib. Kelasnya himpunan tertutupfinal,gemination,prenasal,glottal. - Setiap langkah trace membawa span input dan output serta menyebut array cluster mana yang diindeksnya. Mencampur keduanya pernah membuat garis penghubung menunjuk glif yang salah.
- Normalisasi NFC dan
Intl.Segmenteruntuk grapheme cluster; tidak pernahstr[i]atau.split('')untuk logika glif. - Korpus diambil dari template
{{multiscript|…}}di dump Wikipedia bahasa Bugis (CC BY-SA 4.0).tests/corpus.test.tsmengunci angka 94% dan mewajibkan setiap ketidakcocokan yang tersisa dijelaskan. Temuan yang belum ditindaklanjuti adalahngp→ MPA dannc→ NYCA. - Semua 1.323 entri leksikon bertanda
attestation: "corpus"danband: "unknown". Sebelum konten bot dibuang, sembilan kata "umum" masing-masing muncul di 617–620 artikel karena mereka keterangan warna di satu keterangan peta yang berulang. data/rules/reviewers.jsonkosong danpnpm gate:checkkeluar dengan kode 1; CI menjalankannya dengancontinue-on-errorsupaya penulis dan halaman konformansi tetap ter-build.- CI menegakkan anggaran JS 200 KB gzip dan mencocokkan daftar precache service worker dengan berkas di disk, lalu mengambil setiap URL-nya. Service worker tidak memakai
skipWaitingdanclients.claimagar build tidak tercampur di tengah sesi. - Teks yang dibagikan disimpan setelah
#di URL, jadi tidak pernah sampai ke log server. - Empat dependensi runtime: Next.js 14.2.15, React 18.3.1, React DOM, dan Zod 3.23.8. Tanpa library transliterasi. Font (Noto Sans Buginese, Gentium Plus, Space Mono) di-subset menjadi 76 KB woff2.
- 281 tes di 6 berkas; 6 rute di dua bahasa, termasuk rujukan aksara lengkap di
/aksara; 12 string sulit di halaman konformansi. - Spesifikasi awal juga mencakup aksara Jawa dan Bali. Saya memangkasnya ke Bugis karena Noto Sans Buginese hanya punya 41 glif dan 2 fitur OpenType. Nulisa ditautkan untuk aksara lain. Urupu, nama asli aksara ini, menjadi nama cadangan.
- Sekitar 9.300 baris kode dan 35 commit dari 30 Juli sampai 4 Agustus 2026, dalam tiga hari aktif.
Tangkapan layar
Sedang merekrut, atau membangun hal serupa?
Saya terbuka untuk posisi full-time dan proyek freelance tertentu.