 AFM Studio
Quranlytics
 Quranlytics
Pembaca Al-Qur'an tempat siapa pun bisa mengecek jumlah kata dan klaim angka di 6.236 ayat
- ayat dari seluruh 114 surah
- 6.236
- kata yang terhubung ke akar Arabnya
- ~50.000
- akar kata untuk dijelajahi
- ~1.650
- status klaim: terverifikasi, diperdebatkan, terbantahkan
- 3
Di halaman ini
Masalahnya
Aplikasi Al-Qur'an seperti Quran.com, Tanzil, dan eQuran dibuat untuk membaca. Tipografinya rapi, ada audio, ada terjemahan. Tapi tidak satu pun yang membiarkan pembaca biasa menelusuri teksnya sendiri. Apakah kata "hari" muncul 365 kali? Ayat mana saja yang menyebut rahmat dan azab sekaligus? Untuk menjawabnya, orang harus membuka konkordansi secara manual.
Ada dua kelompok yang merasakan celah ini. Pembaca sehari-hari dan pelajar sering menemukan klaim "mukjizat" angka atau bahasa di internet, tanpa cara untuk mengeceknya. Kreator konten dakwah ingin mengutip pola tertentu, seperti jumlah kata atau pengulangan kalimat, tanpa perlu alat riset akademik. Quranlytics menaruh pembaca dan lapisan analisis di atas data yang sama, jadi menjelajah tidak pernah berarti keluar dari aplikasi.
Yang saya bangun
Semua hitungan saya siapkan di awal
Menghitung satu akar kata di 6.236 ayat dan sekitar 77 ribu kata terlalu lambat kalau dilakukan setiap kali diklik. Saya menghitung frekuensi kata, akar, dan frasa lebih dulu lalu menyimpannya, dengan cache di depannya. Saat pembaca membuka sebuah klaim, angkanya sudah tersedia. Interaksi utamanya, klik klaim lalu lihat hasil pengecekannya, tetap instan.
Dua sumber, digabung kata demi kata
Data Quran.com berisi teks ayat dan terjemahan, tapi tanpa akar kata. Quranic Arabic Corpus punya akar katanya, dengan kunci posisi setiap kata. Saya mengambil keduanya dan menggabungkannya kata demi kata berdasarkan posisi itu. Sekitar 50 ribu dari 77 ribu kata punya akar tiga huruf, tersebar di kira-kira 1.650 akar yang berbeda. Sisanya partikel dan nama diri. Parser awal saya mengambil akar dari awalan dan akhiran kata, padahal seharusnya dari kata dasarnya. Saya memperbaikinya dan menambah tes begitu data yang salah itu ketahuan.
Pencarian berjalan dengan model di dalam aplikasi
Rencana awalnya memakai layanan AI pihak ketiga untuk pencarian semantik. Saya menjalankan model multibahasa terbuka di dalam container aplikasi sendiri. Model itu membuat embedding setiap ayat dari terjemahan Inggris dan Indonesianya, mencari ayat yang berkaitan, dan mengelompokkannya ke dalam tema. Teksnya tidak pernah berubah, jadi semua ini cukup dihitung sekali. Tidak ada biaya per pencarian, dan fiturnya jalan tanpa internet.
Pengecek klaim memberi satu dari tiga jawaban
Klaim angka tentang Al-Qur'an banyak beredar di internet seolah sudah pasti benar. Pengecek memberi setiap klaim satu status: Terverifikasi, Diperdebatkan, atau Terbantahkan. Ini mengikuti batas lingkup proyek. Aplikasi menampilkan datanya dan tidak menyimpulkan apa yang dibuktikan sebuah pola. Kesimpulannya diserahkan kepada pembaca.
Semua alat bisa dipakai tanpa akun
Membaca dan semua alat analisis terbuka untuk umum. Login hanya menambahkan bookmark, catatan, progres bacaan, dan streak. Akun tidak pernah membuka fitur inti.
Hasilnya
Saya membangun Quranlytics sendirian dalam 14 hari, dari repositori kosong pada 24 Juni sampai 7 Juli 2026. Isinya mencakup seluruh 114 surah dan 6.236 ayat. Sekitar separuh pekerjaannya berupa fitur di luar rencana awal. Di antaranya pewarnaan tajwid, mode hafalan, murattal berkelanjutan dengan pilihan qari, dan perencanaan khatam. Saya juga menambahkan penampil struktur kiastik yang mewarnai pasangan ayat yang saling bercermin, penjelajah Asmaul Husna dan 25 nabi yang disebut namanya, serta lapisan komunitas untuk berbagi temuan. Kodenya terbuka di GitHub dan pipeline deploy-nya sudah siap. Aplikasinya belum live di alamat publik.
Di balik layarDetail teknis untuk engineer
- Backend: Django 5.0 dan DRF dengan SimpleJWT, terbagi di 6 app (
quran,analytics,semantic,users,community,common). - Frontend: Next.js 14.2 App Router, React 18.3, TypeScript 5.5 mode strict, dan Tailwind CSS 3.4. Satu-satunya dependensi di luar inti adalah
html-to-imageuntuk ekspor PNG. Grafik dan komponen UI dibuat sendiri. - Management command
compute_statsdanbuild_frequency_cachemengisi tabel PostgreSQL. Redis menyimpan cache hasilnya selama 24 jam. - Proses impor menggabungkan data Quran.com dan QAC 1:1 pada
surah:verse:word, membatasi laju sesuai batas API sumber, dan mencoba ulang saat mendapat HTTP 429. - Perbaikan morfologi mengambil lemma, akar, dan kelas kata dari stem, tidak dari segmen klitik.
- Quran.com mengganti ID terjemahan Sahih International dari 131 ke 20 dan berhenti mengirim
verse_key, jadi terjemahan kini dipetakan berdasarkan posisi. - Normalisasi pencarian Arab disatukan sekali, lalu diperbaiki tiga kali lagi: ال di awal kata, kata berawalan ال di pencarian kemunculan bersama, dan lemma polos di contoh.
- Lapisan semantik:
sentence-transformersditorchversi CPU, vektor dipgvector, dan KMeans untuk klaster tema. Dependensi ML dipisah diml.txt, jadi aplikasi dasar dan CI bisa jalan tanpanya. - Alat lain: heatmap frekuensi kata di 114 surah, penjelajah akar dengan pohon morfologi, pencarian kemunculan bersama, pencari hapax legomena, simetri pasangan surah, grafik panjang ayat, dan penjelajah pengulangan kalimat.
- GitHub Actions menjalankan tes di setiap push dan menerbitkan image ke GHCR. Sentry aktif di produksi.
- Sekitar 35 endpoint REST dan 20 route utama. Sekitar 6.900 baris Python dan 9.900 baris TypeScript, 121 commit dengan 26 merge commit dari sekitar 28 branch fitur.
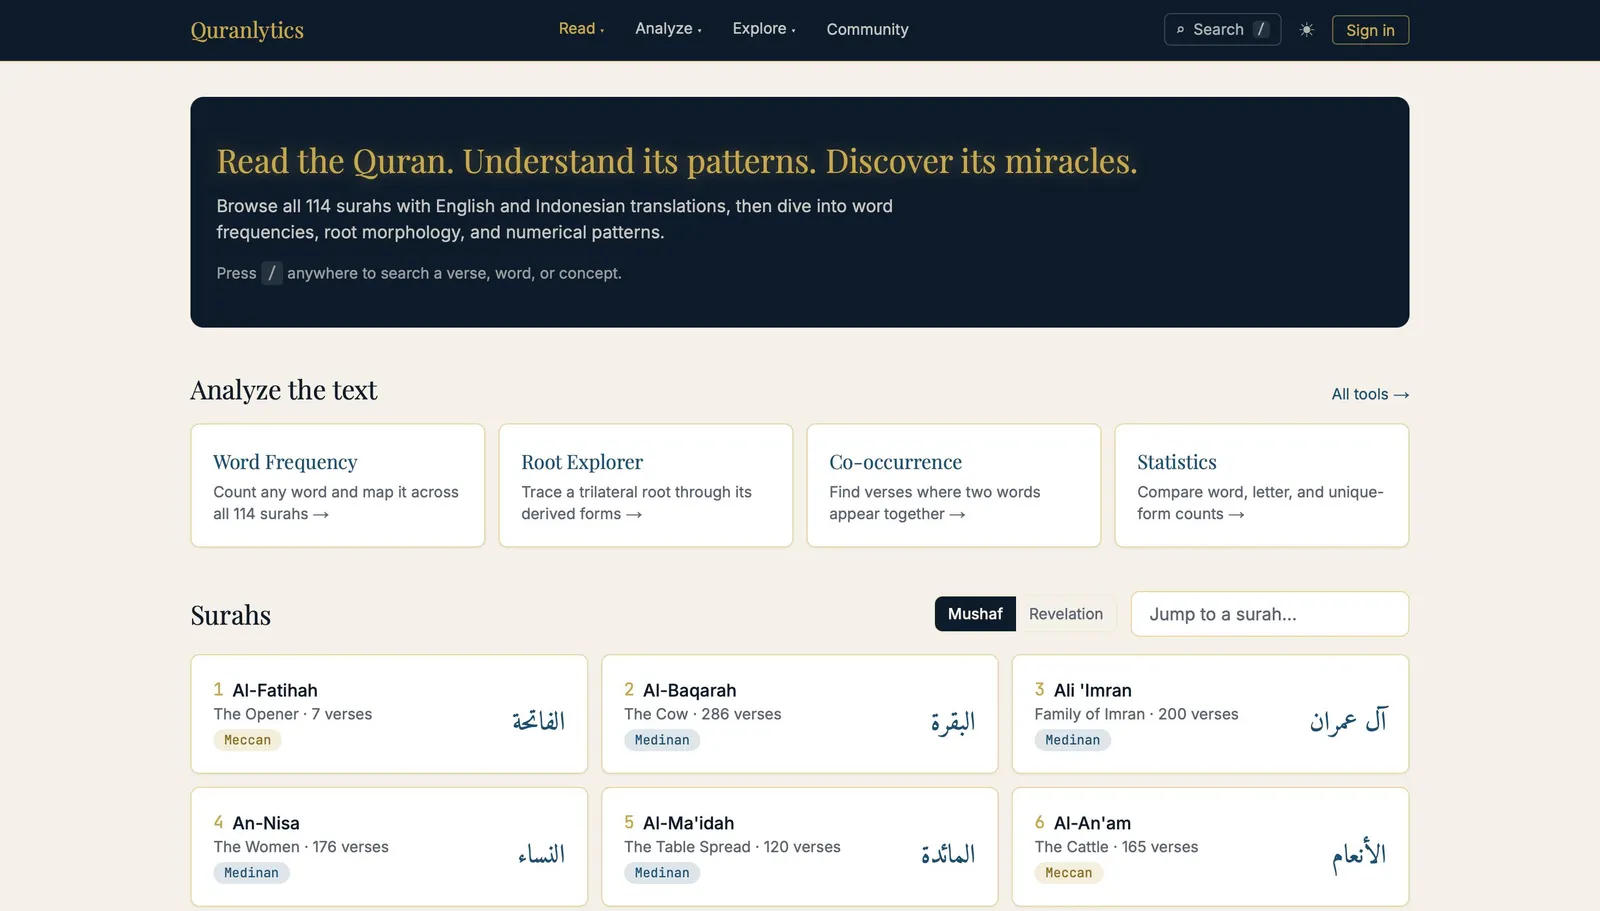
Tangkapan layar
Sedang merekrut, atau membangun hal serupa?
Saya terbuka untuk posisi full-time dan proyek freelance tertentu.