 AFM Studio
Stemmer Visualizer
 Stemmer Visualizer
Tampilan langkah demi langkah cara kata Indonesia dikupas ke kata dasarnya, termasuk jalan buntu dan akar ganda
- kata dasar di kamus yang bisa diubah
- ~30.000
- aturan stemming disimpan sebagai data bersumber
- 44
- kata dibandingkan dengan Sastrawi, perbedaannya diklasifikasi
- 315
- library NLP saat runtime
- 0
Di halaman ini
Masalahnya
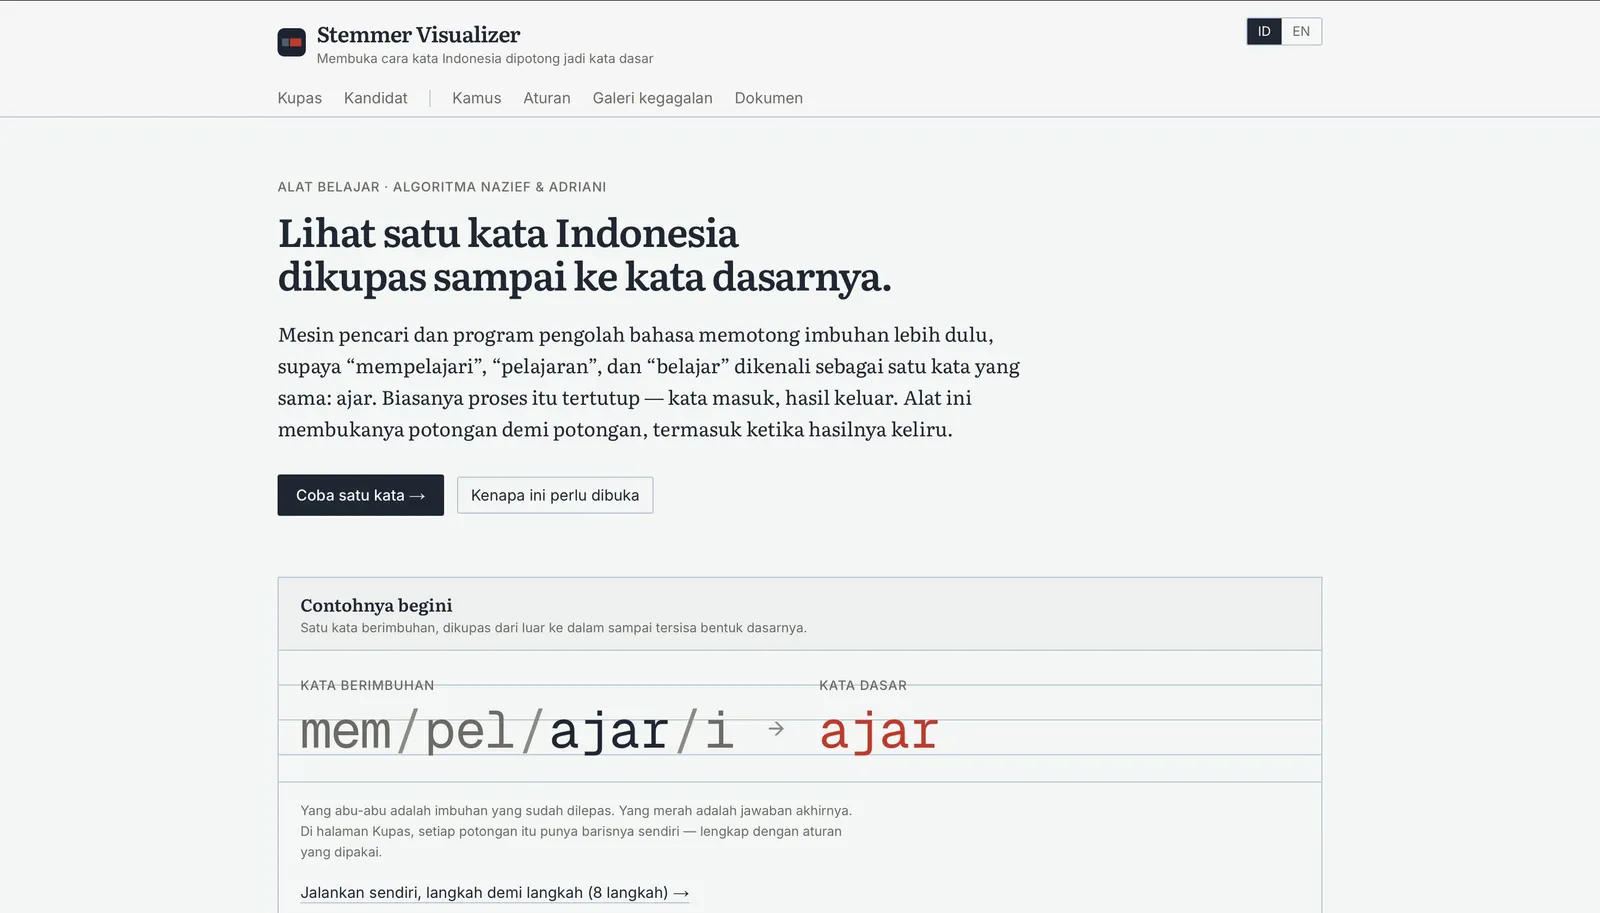
Hampir semua mesin pencari dan alat bahasa untuk bahasa Indonesia terlebih dulu mengembalikan kata ke bentuk dasarnya, supaya mempelajari, pelajaran, dan belajar sama-sama dihitung sebagai ajar. Langkah ini disebut stemming. Di Indonesia, stemming hampir selalu memakai algoritma Nazief dan Adriani, biasanya lewat library Sastrawi, sebagai kotak hitam: kata masuk, kata dasar keluar.
Ini membawa tiga masalah bagi mahasiswa, dosen, dan developer yang mengandalkannya. Kata dasar yang salah terlihat sama dengan yang benar, karena keduanya tetap kata Indonesia yang masuk akal. Hasilnya bergantung pada kamus kata dasar yang tersembunyi, sama besarnya dengan bergantung pada aturannya. Lalu ada kata yang punya dua kata dasar yang sah. Beruang bisa berarti ber- ditambah uang ("punya uang") atau kata dasar beruang (hewan). Algoritmanya memilih salah satu tanpa memberi tahu.
Yang saya bangun
Setiap langkah tampil di layar, termasuk jalan buntunya
Ketik sebuah kata, dan jejaknya menampilkan setiap langkah sebagai baris bernomor: apa yang dilepas, aturan mana yang melakukannya, kata sebelum dan sesudahnya, dan apakah kamus mengenali hasilnya. Langkah yang dicoba lalu ditinggalkan tetap terlihat, dicoret dengan warna abu-abu. Anda bisa menelusurinya selangkah demi selangkah, dan sebuah animasi mengupas setiap awalan atau akhiran dari katanya.
Aturannya berupa data yang bisa dibaca ahli bahasa
Tidak satu pun dari 44 aturan ditulis sebagai kode. Setiap aturan disimpan di berkas data lengkap dengan polanya, efeknya, prioritasnya, dan kutipan sumbernya. Mesinnya membaca berkas itu lalu menerapkannya. Ahli bahasa bisa memeriksa aturannya tanpa membaca kode, dan jejaknya bisa menyebut aturan persis yang dipakai. Build gagal kalau ada aturan tanpa kutipan.
Kamusnya bisa diubah
Saya menjadikan kamus sebagai masukan eksplisit untuk setiap perhitungan. Panel kamus memungkinkan Anda mencari, menambah, atau menghapus kata, lalu melihat stem yang tadinya benar menjadi rusak. Perubahan tersimpan di link, jadi keadaan yang rusak itu pun bisa dibagikan. Tampilan perbandingan menunjukkan kata yang sama dengan dan tanpa kamus, sehingga terlihat jelas apa sumbangan kamusnya.
Kata yang ambigu mendapat lebih dari satu jawaban
Aturan yang sama menjalankan dua penelusuran. Yang pertama mengikuti algoritma dan mengembalikan satu jawaban. Yang kedua menjelajahi semua cara kata itu bisa dipecah. Untuk beruang, aplikasi menampilkan kedua kata dasar yang sah dan menjelaskan alasan algoritma memilih salah satunya. Galeri enam kata yang salah dihitung algoritma ini dihitung ulang secara langsung, masing-masing diberi label cara dan titik kegagalannya.
Sastrawi menjadi pembanding untuk pengujian
Saya membandingkan hasil saya dengan Sastrawi pada 315 kata dan menemukan sembilan perbedaan. Tiga di antaranya bug saya: dua entri kamus yang salah dan satu aturan yang terlewat. Enam sisanya diklasifikasikan secara tertulis, dan setiap perbedaan dikunci oleh tes supaya tidak ada yang mengubahnya diam-diam. Makalah aslinya tidak bisa saya dapatkan, jadi setiap aturan ditandai belum terverifikasi dan ada berkas celah yang mencatat di mana harus memeriksanya.
Hasilnya
Stemmer Visualizer sudah live, terbuka untuk umum, dan open source, dalam bahasa Indonesia dan Inggris, serta bisa dipakai offline. Ada tujuh halaman, termasuk referensi aturan yang dibangkitkan dari data aturannya dan mode dokumen yang menandai kata ambigu dalam paragraf yang ditempel. Aplikasi ini memakai daftar kata dasar Sastrawi yang berisi sekitar 30.000 kata. Perubahan itu memperbaiki dua perbedaan tetapi merusak satu kata, perusakan, yang kini menghasilkan rusa. Saya menerimanya dan mencatatnya. Situs ini menautkan Sastrawi sebagai library yang sebaiknya dipakai di produksi. Saya membangunnya dalam sekitar sembilan jam pada 5 Agustus 2026.
Di balik layarDetail teknis untuk engineer
- Mesin di
lib/engine/terdiri dari tujuh modul murni. Signature:(word, variant, ruleSet, dictionary) → StemTrace. Tanpa React, DOM, jam, atau state modul; masukan yang sama menghasilkan jejak yang identik sampai ke byte. interpret.tsmengikuti prioritas;enumerate.tsmenjelajahi setiap segmentasi. Tes menguji kesahihan (kata dasar yang dikembalikan ada di himpunan kandidat), bukan kesamaan.- Aturan disimpan di
data/rules/na96.jsondengan id tetap sepertina96.awalan.me.luluh.ny.pnpm rules:validatememeriksa skema, kutipan, dan konflik prioritas dengan Zod, dan menjadi gerbang build serta deploy. - Ke-44 aturan bertanda
verification: "unverified". Makalah 1996, perluasan 2005, dan versi TALIP 2007 tidak bisa didapat;data/rules/GAPS.mdmencatat apa saja yang sudah dicoba. Sebuah tes menguji jumlah aturan yang belum terverifikasi, jadi memverifikasi satu aturan memaksa tes itu diperbarui. - Oracle: PySastrawi 1.2.1 pada 315 kata → 9 perbedaan. Yang diperbaiki:
hargaidansertaiyang keliru tercatat sebagai kata dasar, serta aturanper-sebelum konsonan yang terlewat (aturan 22), yang sekaligus memperbaiki pertemuan → temu. Enam sisanya diklasifikasikan ditests/oracle/divergences.md. - Tes dikunci ke kamus kurasi 293 kata, karena semua fixture ditulis berdasarkan kamus itu. Daftar yang dirilis berisi 29.932 kata (sekitar 290 KB), disertakan sebagai data di bawah lisensi MIT Sastrawi dan dimuat sebagai chunk tersendiri agar JS aplikasi tetap di bawah 200 KB gzip. Tidak ada kode Sastrawi yang ikut dirilis.
- Varian 2005 baru sebagian: perbandingan tanpa kamus sudah ada, tetapi paket aturannya harus dikarang kalau dibuat sekarang, jadi belum ada.
- Abu-abu pensil dipecah menjadi dua nada supaya teks sekunder lolos WCAG AA. Proyek ini bernama Kupas di PRD;
kupasmasih dipakai sebagai rute halaman jejak. - Static export Next.js 14, 7 rute × 2 bahasa, 20 komponen, lima dependensi runtime tanpa library NLP. 59 tes Vitest di 6 berkas. Sekitar 5.480 baris, 42 commit.
Tangkapan layar
Sedang merekrut, atau membangun hal serupa?
Saya terbuka untuk posisi full-time dan proyek freelance tertentu.